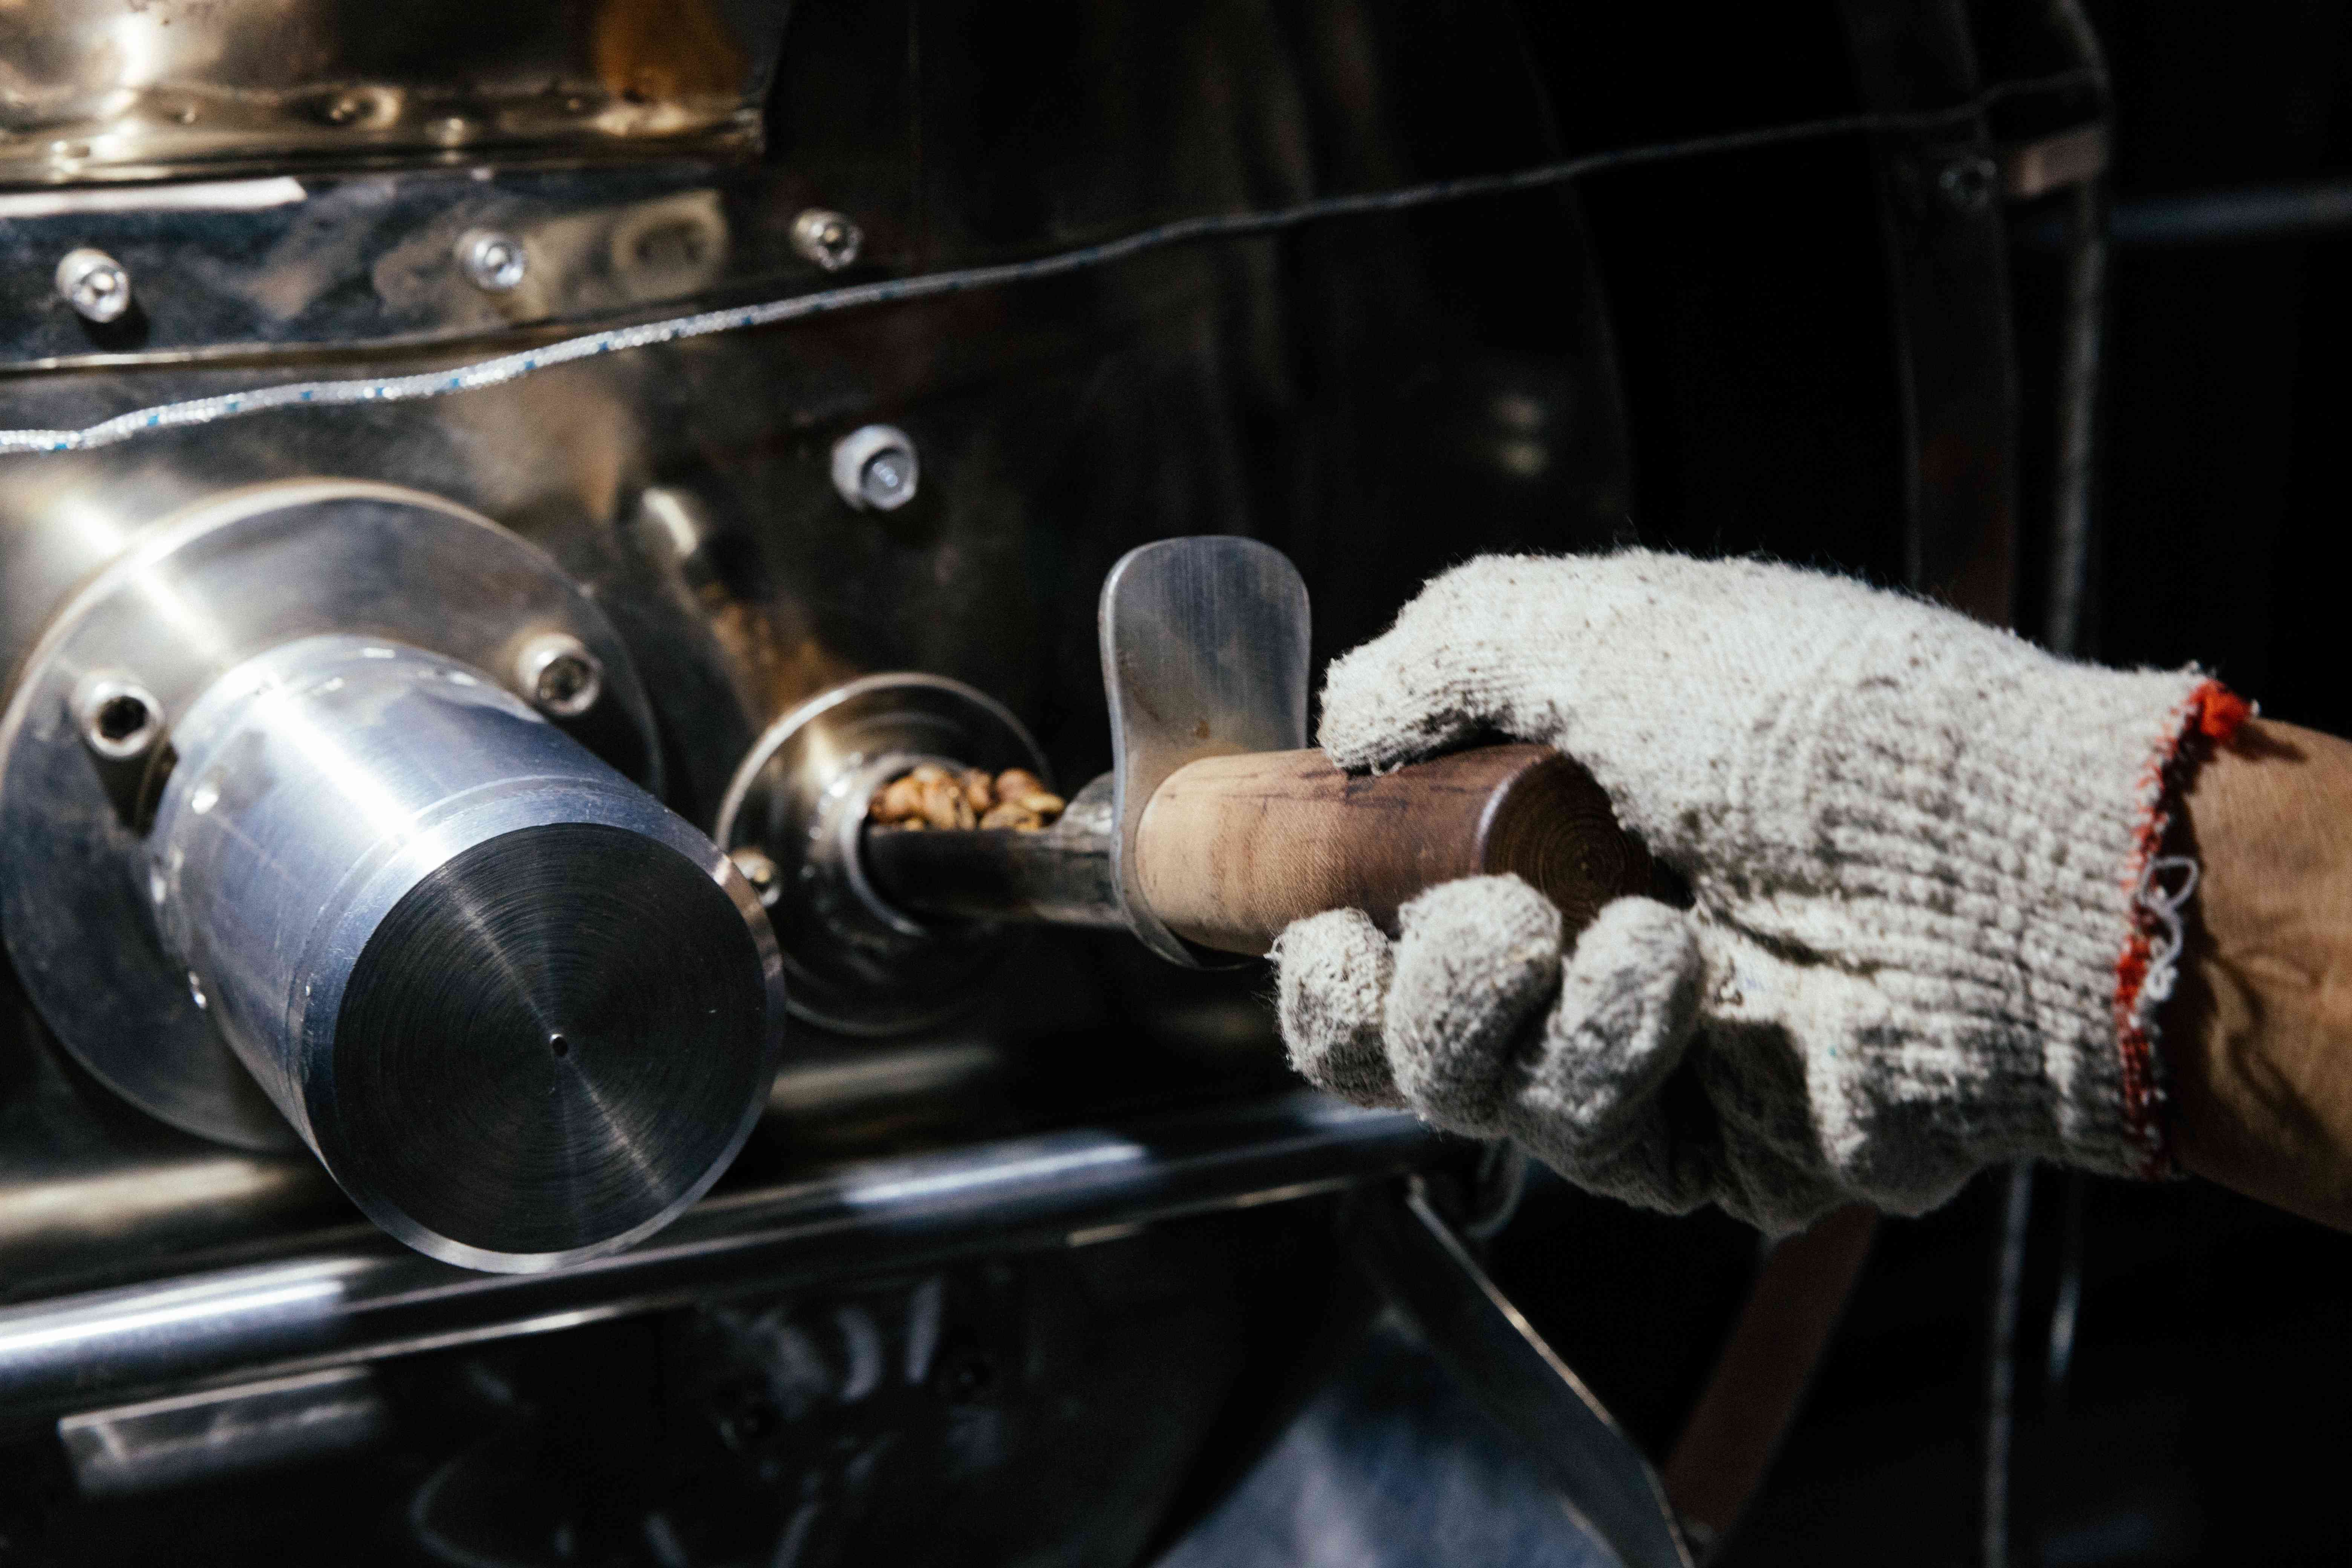
Rang làm thay đổi thành phần và lượng chất bay hơi phát ra từ hạt. Dãy cảm biến phản ứng với các thay đổi đó theo mức độ khác nhau, tạo thành một mẫu hình tổng hợp. Các nghiên cứu đã cho thấy electronic nose có thể phân biệt cà phê chịu các mức xử lý nhiệt khác nhau khi tín hiệu được xử lý bằng PCA, PLS-DA hoặc mô hình phân loại. Tuy nhiên, tín hiệu cũng chịu ảnh hưởng của nguyên liệu và môi trường. Nếu profile rang được thay đổi đồng thời với nguồn nguyên liệu hoặc ngày đo, mô hình có thể học một khác biệt không liên quan đến rang.
Từ cảm biến đến ma trận
Mỗi cảm biến tạo tín hiệu theo thời gian; nhiều cảm biến tạo thành ma trận dữ liệu. Trước phân tích, có thể cần hiệu chỉnh nền, chuẩn hóa hoặc trích xuất đặc trưng. Những bước này quyết định phần nào của tín hiệu được giữ lại. Nếu tham số xử lý được tối ưu trên toàn bộ dữ liệu trước khi chia huấn luyện và kiểm tra, kết quả có thể bị lạc quan. Quy trình xử lý phải được xây dựng sao cho tập kiểm tra thực sự độc lập. Khi dùng lâu dài, còn cần theo dõi độ trôi của cảm biến vì trạng thái cảm biến có thể thay đổi theo thời gian.
Vai trò của chemometrics
PCA hữu ích để quan sát cấu trúc và xem các mẫu có tạo thành nhóm hay không. Khi mục tiêu là phân loại, PLS-DA hoặc các mô hình học máy có thể được dùng. Vai trò của mô hình là biến ma trận cảm biến thành quyết định phân biệt, không thay thế việc hiểu dữ liệu. Một mô hình có thể phân tách đẹp trên tập huấn luyện nhưng thất bại với mẫu mới. Vì vậy, cần đánh giá trên dữ liệu độc lập hoặc xác thực chéo được thiết kế đúng với đơn vị độc lập của nghiên cứu.
Kiểm chứng và chống overfitting
Nếu nhiều phép đo đến từ cùng một mẻ mà được chia ngẫu nhiên vào cả huấn luyện và kiểm tra, mô hình có thể học dấu vết của mẻ. Với mục tiêu sản xuất, tách theo mẻ, lô hoặc thời gian thường có ý nghĩa hơn. Nghiên cứu electronic nose năm 2022 cho thấy PCA và PLS-DA có thể phân biệt các mẫu rang khác nhau, nhưng kết quả đó phải được hiểu trong phạm vi thiết kế nghiên cứu. Độ chính xác không thể tách khỏi tập mẫu và điều kiện đo tạo ra nó.
Vị trí trong kiểm soát chất lượng
Mũi điện tử có lợi thế về tốc độ và đo không phá mẫu, nên có thể phù hợp cho sàng lọc hoặc theo dõi xu hướng. Nhưng tín hiệu thường là bằng chứng gián tiếp. Muốn biết khác biệt đến từ hợp chất nào hoặc có ý nghĩa cảm quan ra sao, có thể cần GC-MS và đánh giá cảm quan. Vì vậy, cách dùng hợp lý là xem electronic nose như một lớp đo bổ sung. Giá trị của hệ thống tăng khi mô hình được kiểm chứng trên dữ liệu mới và có quy trình kiểm tra độ trôi của cảm biến.
Độ ổn định của cảm biến
Electronic nose nhạy với nhiệt độ, độ ẩm, thời gian cân bằng và trạng thái cảm biến. Cùng một mẫu có thể cho tín hiệu khác nếu điều kiện đo thay đổi. Vì vậy, hệ thống dùng lâu dài cần theo dõi nền và độ trôi của cảm biến. Việc hiệu chuẩn hoặc kiểm tra định kỳ không chỉ nhằm giữ độ chính xác; nó giúp phát hiện khi mô hình đang nhận dữ liệu khác với dữ liệu dùng để huấn luyện. Nếu bỏ qua bước này, một hệ thống phân loại profile rang có thể dần học đặc điểm của thiết bị thay vì đặc điểm của cà phê.
Từ mô hình phân loại đến khả năng sử dụng
Một mô hình phân loại có giá trị khi nó gắn với quyết định cụ thể. Nếu mục tiêu là sàng lọc nhanh các mẻ nghi ngờ, mô hình không nhất thiết phải phân biệt mọi profile rất chi tiết. Nếu mục tiêu là xác nhận một profile sản xuất, yêu cầu về mẫu độc lập và độ ổn định sẽ cao hơn. Cũng cần xem chi phí của lỗi: bỏ sót một mẻ bất thường và cảnh báo nhầm một mẻ bình thường không có hậu quả giống nhau. Vì vậy, chỉ số hiệu năng nên được chọn theo quyết định sử dụng, không chỉ theo thuật toán. Đây là bước giúp tránh tình trạng mô hình đạt độ chính xác cao nhưng không có quy trình hành động rõ ràng.
Độ đại diện của tập mẫu
Một mô hình phân biệt profile rang cần được kiểm tra trên những biến thiên mà ứng dụng thực tế sẽ gặp. Nếu dữ liệu chỉ gồm một giống, một nguồn và một ngày rang, mô hình có thể học những dấu vết phụ rất mạnh. Khi mở rộng sang nguyên liệu khác, hiệu năng có thể giảm dù thuật toán không thay đổi. Vì vậy, việc chia dữ liệu theo mẻ hoặc lô có ý nghĩa hơn chia ngẫu nhiên từng phép đo. Một bộ kiểm tra độc lập đặc biệt quan trọng nếu hệ thống dự kiến được dùng cho những mẻ chưa từng xuất hiện trong quá trình huấn luyện. Đây là điều kiện để độ chính xác trở thành bằng chứng có thể chuyển giao.
Tài liệu tham khảo
- Barea-Ramos J. D. et al. (2022). Sensors, 22, 8654. DOI: 10.3390/s22228654.
- Hong S. J. et al. (2024). Food Chemistry: X, 21, 101119. DOI: 10.1016/j.fochx.2024.101119.
- Dong et al. (2019). Food Chemistry, 272, 723–731. DOI: 10.1016/j.foodchem.2018.08.068.
- Shi et al. (2025). Food Chemistry, 481, 144079. DOI: 10.1016/j.foodchem.2025.144079.
Roasting changes the composition and amount of volatile compounds released from the bean. A sensor array responds to those changes at different degrees, forming a combined pattern. Studies have shown an electronic nose can distinguish coffee subjected to different thermal treatments when the signal is processed with PCA, PLS-DA, or a classification model. However, the signal is a combined response across many sensors, so interpreting it requires suitable statistical handling rather than reading any single sensor in isolation.
From sensor to matrix
Each sensor produces a signal over time; multiple sensors form a data matrix. Before analysis, baseline correction, normalization, or feature extraction may be needed. These steps determine which part of the signal is retained. If processing parameters are optimized on the entire dataset before splitting into training and test sets, the result can be overly optimistic. The procedure needs to keep test data genuinely independent from the steps used to build the model.
The role of chemometrics
PCA is useful for observing structure and seeing whether samples form groups. When the goal is classification, PLS-DA or machine-learning models can be used. The model's role is turning the sensor matrix into a discriminative decision, not replacing an understanding of the data. A model can separate classes beautifully on training data but fail on new samples. So validation needs a design that reflects real conditions of use.
Validation and guarding against overfitting
If multiple measurements from the same batch are randomly split into both training and test sets, the model can learn the batch's own fingerprint. For production purposes, splitting by batch, lot, or time usually makes more sense. A 2022 electronic-nose study showed PCA and PLS-DA can distinguish different roast samples, but that result must be understood within the scope of the specific dataset and split method used.
Position within quality control
An electronic nose has an advantage in speed and non-destructive measurement, making it suitable for screening or trend tracking. But the signal is usually indirect evidence. To know which compound drives a difference or what it means sensorially, GC-MS and sensory evaluation may still be needed. So the sensible use is treating the electronic nose as a supplementary measurement layer. Its value lies in speed and consistency, not in replacing chemical identification or human evaluation.
Sensor stability
An electronic nose is sensitive to temperature, humidity, equilibration time, and sensor condition. The same sample can produce a different signal if measurement conditions change. So a system used long-term needs to monitor baseline and sensor drift. Periodic calibration or checking isn't just for maintaining accuracy; it helps detect when the model is receiving data different from what it was trained on.
From a classification model to usability
A classification model has value when tied to a specific decision. If the goal is quickly screening suspect batches, the model doesn't necessarily need to distinguish every profile in fine detail. If the goal is confirming a production profile, the requirements for independent samples and stability will be higher. You also need to weigh the cost of errors: missing an abnormal batch versus a false alarm may carry different costs depending on the application.
Representativeness of the sample set
A model distinguishing roast profiles needs to be tested on the variation real applications will encounter. If the data only includes one variety, one source, and one roasting day, the model may learn very strong side artifacts. When extended to other raw material, performance can drop even though the algorithm hasn't changed. So splitting data by batch or lot has more meaning than a purely random split for assessing real-world generalization.
References
- Barea-Ramos J. D. et al. (2022). Sensors, 22, 8654. DOI: 10.3390/s22228654.
- Hong S. J. et al. (2024). Food Chemistry: X, 21, 101119. DOI: 10.1016/j.fochx.2024.101119.
- Dong et al. (2019). Food Chemistry, 272, 723–731. DOI: 10.1016/j.foodchem.2018.08.068.
- Shi et al. (2025). Food Chemistry, 481, 144079. DOI: 10.1016/j.foodchem.2025.144079.